GPT-6 Astra:3D、具身智能及其他
1. 关于Astra
OpenAI并未公开太多GPT-6 Astra的具体构建方式。我们目前能够确认的,以及外界正在流传的信息,大致如下:
- OpenAI公开:在Stargate的超过10万块GPU上进行预训练,这是其迄今为止规模最大的训练运行;大规模强化学习;以及针对computer use的“面向专业环境的定向训练”。System card没有披露算力、环境或架构,关于数据仅说了“多样化的数据集”。 -据报道未证实:购买了数万台Mac mini和Mac Studio用于强化学习和训练computer-use agent,以及采用了一种looped transformer架构。 -无法证实的传闻:这些Mac上可能使用Blender作为训练环境;训练中也可能已经加入了某种形式的机器人操作数据或第一人称人类数据。
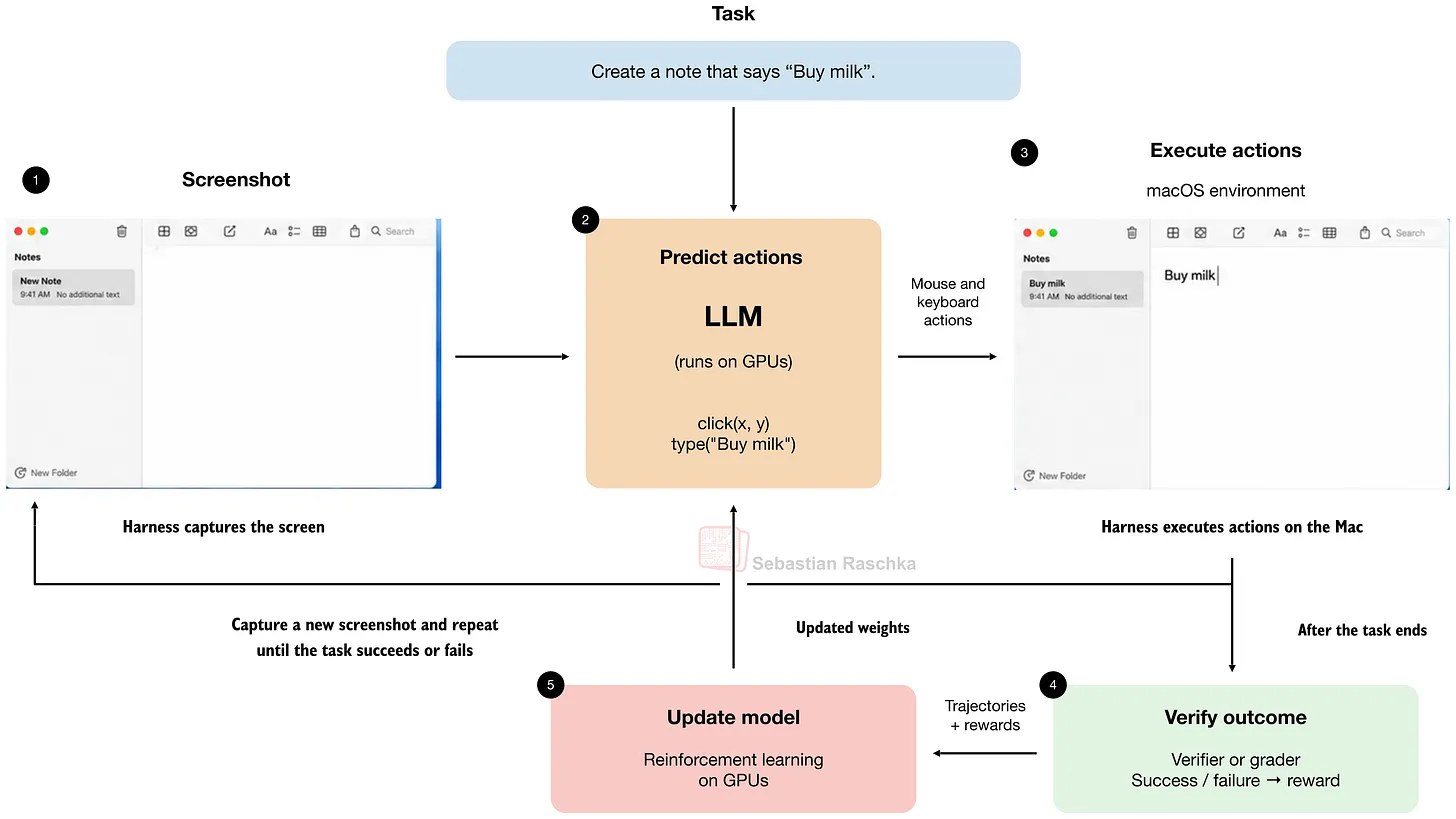
综合来看,GPT-6的进步似乎主要来自训练数据和训练recipe,而非架构。
2. Astra与3D
人们最先注意到的能力,也是OpenAI自己重点展示的,是3D。更准确地说,是逆向图形学(inverse graphics)。
正向问题是渲染:给定场景配置(几何、材质、光照、相机等),产生图像。Inverse graphics是这个问题的反面:给定一张图像或一段视频,恢复出一个能在渲染器中复现它的场景。Astra最初展示的就是这类能力,起点是Blender,之后自然也可以延伸到其他simulator。模型做的事并不复杂:写(Blender)代码,渲染,检查图像,找出问题,决定改什么,然后重复。这与coding agent写代码或做幻灯片没有本质区别。区别只在于,现在它运行在一个3D engine里面。对于coding agent来说,compiler和sandbox提供了执行环境;对于Astra来说,Blender扮演的是类似的角色。
Astra现在的能力当然并非完美。它擅长规则几何体和多面体,但如果让它直接建模一个人或者一头牛,结果往往就比较差。这一点很多人已经从demo中看到了。但这并不是一个无法解决的问题。一种很自然的方法,是给Astra接入更多专用工具,让它在需要的时候调用这些工具,例如image-to-3D生成器(如Meshy或Hyper3D),或专门的人体重建模型。一旦这些工具被放进同一个loop中,Astra自己的空间推理能力就可以和这些专用工具叠加起来,能力也会随之增强。我们已经看到一些这方面的早期的结果,接下来还会看到更多。
另一个值得注意的方向,是它和视频生成的互补关系。视频生成的一大难题是可控性,而图形引擎中的结果天然可编辑;它们可以为视频生成提供很好的condition。反方向亦然:在Blender中搭建的场景看起来就是“游戏画面”;视频生成可以让模拟的3D场景在外观上显得逼真。当然,视频生成本身也可以作为工具接入。
如果说inverse graphics还有什么真正困难、同时又最值得继续解决的问题,我认为是逆向物理(inverse physics):从观测推断物理参数,使模拟不仅能复现场景的外观,还能真正与之交互。物理包罗万象,从小球在斜面上的运动,直到流体、湍流和天体物理系统的运行规律。输入一段视频,恢复其全部物理规律,你就得到了传说中的世界模型(world model),一个全知全能的模拟器。
我们显然还没到那一步,那么差距究竟在哪里?物理是Astra或下一代GPT射程之外的吗?它需要一条根本不同的路径,还是只需沿着现有路径继续扩展?我们在后文会再谈到这个问题。
3. Astra与具身智能
第二个问题是Astra对具身智能意味着什么。在我看来,至少在以下几个层面,它带来了一种新的可能性。
第一,编排(orchestration)。 给定一组打包为工具的基础能力,它可以充当orchestrator:规划任务、调用工具、检查结果,调用失败时重试,正如我们此前在Thea中展示的那样。更强的模型具备更可靠的空间推理和工具调用能力,自然可以是更好的orchestrator。
工具使用可以处于不同的粒度。一种选择是在中间放一个policy,如操作模型或导航模型,供模型调用。另一种是直接调用底层机器人SDK:调整相机以实现主动感知,调用move_base进行精细导航,甚至直接输出末端执行器位置,由motion planning填充关节角度。这是Astra最引人注目的能力:它能产生直接的控制信号,而且做得相当不错。随着模型能力提升,抽象层级不断下降,这使得cross-embodiment和zero-shot成为可能。
Astra这样的模型也可以反过来帮助我们训练更好的policy model。每一步都调用大模型太过笨重,因此蒸馏出一个能在端侧高频运行的policy是有意义的。如上所述,模型本身可以产生好的演示数据demonstrations。把它想象成一个坐在屏幕前的遥操作员。它可以采集大量遥操作数据,这些数据可以蒸馏为更小的policy模型。另一种可能性则来自3D一侧的能力:real-to-sim-to-real。我们可以用这种方式训练一个好的policy,无论是通过合成演示数据,还是直接进行RL。
我预计接下来一定会发生的一件事,是像Astra这样的基础模型会在更多真实世界交互数据上训练。Astra是否已经在机器人数据上训练过?Jiafei Duan提出这个问题,做了一些实验,并发起了一个投票。无论答案现在是什么,我认为即使这件事情还没有发生,也很快会发生:不同本体的机器人数据,以及人类数据,会被加入到基础模型的训练中。
我们需要做的只是定义模型的输入,比如图像加一些文本;定义动作输出,使模型能描述并解码它们。这里当然存在一些技术问题,比如如何将连续动作符号化或token化,但我看不到根本性的障碍。这就是SFT。一旦完成,VLA架构实际上已被吸收进基础模型。之后,模型可以通过在线交互来继续训练,无论在物理沙盒,还是在物理世界中。这就是RL。
通过与现实世界的交互来学习是一个非常ambitious的目标,有许多实际困难。但这个目标是如此的迷人,因为它代表了一个终极愿景:与物理世界交互所形成的具身体验,将塑造智能本身。
沿着这条路,还剩什么(至少目前)未解决?接触密集型操作。新的传感模态,尤其是触觉。高自由度控制:全身和灵巧操作。这些问题能不能,或者会不会很快地被沿着同一条路线解决?
不管怎样,Astra在这些问题上也已展现出惊人的能力。它并不是通过控制手本身,而是自己搭建产生policy的整个管线:搭建模拟、编写奖励、自行运行RL训练。例如,可以给它这样的任务:
这里还有一个观察。把前文讨论的3D和具身两部分放在一起看,如果我们为精细灵巧操作训练一个专用“小”模型,那么它是不是和构建一个精细的3D重建或生成工具非常相似?
两者的位置恰巧存在一个有意思的对应。在3D中,模型自己处理规则几何体,因为规则几何体很容易用代码表达。在操作任务中也是一样:它可以自己处理低自由度任务,因为这些任务容易表达,而且所需的自由度和控制精度都相对有限。对于更高精度的任务,无论是生成还是控制,它都需要调用专门的专家工具。
两个暴论:第一,基于视觉的低自由度操作的泛化问题在今天仍是一个主要问题,但它会很快被解决;第二,具身智能的所谓GPT时刻,很可能从传统意义上被视为语言模型的那一侧到来。
4. 我的看法
从第一性原理出发,智能有两个来源:数据,以及与环境的交互。而数据本身亦是人类与环境交互的产物,经过蒸馏;语言即是一例。今天,基于互联网数据的多模态预训练是具有一定通用性的最高效的智能来源,因为其中智能的密度高,且数量可扩展。它显然不是唯一的路径;生物演化就走了另一条路。但对于构建人工智能而言,从工程角度看,这仍是目前看来最高效合理的路径,甚至很可能是迄今为止唯一真正可行的路径。
至于“互联网数据用完之后怎么办”,这一讨论其实已经持续了一段时间。现在,这条路径正变得越来越清晰:在一个交互式沙盒中进行agentic RL。
这个沙盒可以是 一台计算机、一个代码库,或是一个3D应用程序。在这样的领域数据上完成SFT和RL之后,模型发展出良好的任务分解与规划、空间推理,甚至与物理世界交互的能力。本质上,这是从语言中预训练出的常识,加上后训练获得的空间推理和决策能力。这样看来,变化的只是数据和训练环境;空间智能和具身智能的实现方式,或许与代码智能并无根本不同。
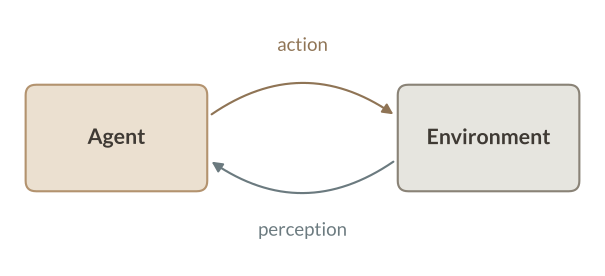
从科学角度看,我从不相信仅靠文本和符号就足以达到通用具身智能。然而,尽管这些模型始于文本上的next-token prediction,情况已不再那么简单。
Perception-action loop is all you need. 对一个agent而言,这是足够本质的表述:感知、行动,以及与环境构成的闭环。有了这个闭环,agent可以在训练时通过RL持续改进,或在测试时通过迭代和自我纠正来改进(我称之为agentic scaling)。从这个角度看,一个不断编辑代码以逼近目标的coding agent,或一个操作键盘鼠标、或写Blender代码、得到结果并改进的computer-use agent,也是一种具身智能。它没有物理身体。但它采取行动,改变其环境,并看到结果。这与智能的发展方式并不矛盾。
现在从这个角度重新看看还剩下什么问题。我们可以从每个问题本身的闭环找到现在的瓶颈:
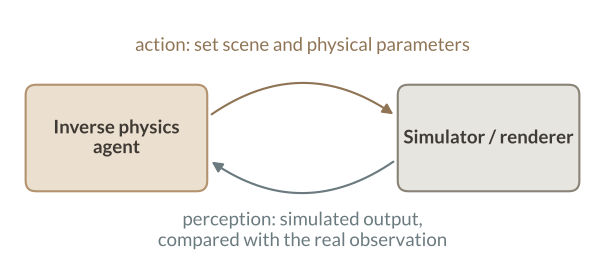
第一,inverse physics agent。 它的action是修改物理参数和规律,perception是将模拟结果与真实世界进行比较。这里的两个瓶颈是:模拟器本身能建模多少物理(在环境一侧,即action箭头),以及4D推理能力,即感知并推理时空物理变化的能力(在agent一侧,即perception箭头)。
当然,有些物理参数(如质量和摩擦),单靠视频是无法恢复的;只有真正对物体施加交互并感受到反馈时,它们才变得可观测。因此这个循环不可能仅仅停留在模拟器内部。最终,它必须通过物理世界完成闭环,而embodied agent就是这个过程中的探测者。反过来,一旦inverse physics被解决,它又可以作为embodied agent循环中的另一头,那将是world model对agent而言的最终形态。
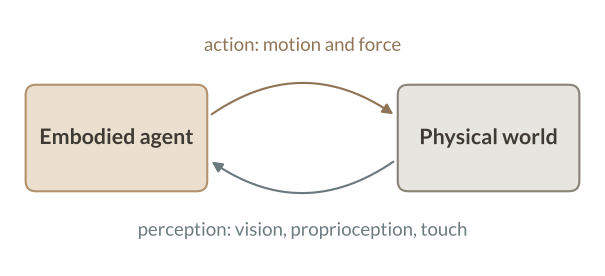
第二,embodied agent。 两个瓶颈分别是:perception侧,传感的丰富度,仅靠摄像头无法捕捉世界中的全部信息,需要触觉等其他感官;action侧,动作空间的表达力和自由度,代码或位姿仍难以表达全身或灵巧控制。如果这些差距被填补,其余部分在本质上或许并无不同:一个perception-action loop,加上预训练、SFT和RL。
这里还有一个值得注意的区别。上述四个瓶颈中,有些是属于模型之外的基础设施:我们对这个世界的物理规律能够理解和模拟到什么程度,传感器能提供的模态与精度如何,以及硬件本身的控制能力。另一些则关乎模型自身:如何将其连接到新模态、理解其信号并处理它们,无论是读取触觉信号还是产生高自由度动作。
这是两种不同类型的问题,它们应该被分别解决。第一类是基础设施,一个更智能的模型并不能自动解决infrastructure的问题。第二类是更强的模型或更好的连接器,真正可能解决的。
| 循环 | 箭头 | 瓶颈 | 基础设施 | 模型或连接器 |
|---|---|---|---|---|
| Inverse physics agent | perception | 4D推理 | — | 推理时空中的物理变化 |
| Inverse physics agent | action | 模拟器能建模的物理 | 模拟器保真度 | — |
| Embodied agent | perception | 传感的丰富度 | 传感器硬件 | 读取、理解新的感官信号 |
| Embodied agent | action | 动作的表达力与自由度 | 硬件控制 | 发出高自由度动作 |
四个瓶颈,分为模型之外的部分(基础设施)和模型或其连接器之内的部分。
5. 我们还能做什么?
过去几天,我想这个领域的每个实验室、每个从业者(也许除了部分OpenAI的研究员)都在思考这个问题。如果借用一句经典台词,我想“激昂和困惑交织在每个人的心头”足够贴切。“激昂”是因为这个领域前进得比以往任何时候都更远更快,“困惑”是因为突然之间,我们不知道还剩下什么可以做、值得做。
坦率地说,对于这个问题我也没有答案。我们应该乐观还是悲观?我们的工作已经被做完了吗?在方法层面,有些问题可能已所剩空间无几,甚至已完全不必再做。但如果我们的目标是一个真正终极的目标,例如通用物理智能,我们比以往任何时候都更接近它。我们现在有一个非常强大的工具,和一条至少部分得到验证的路线。而从这个意义上说,大多数研究者、甚至大多数组织之间的差距反而缩小了。对于这个问题而言,无论你有八块GPU还是两百块,可能并没有很大的区别,除了少数能训练Astra级别基础模型的组织。
无论如何,变化已经发生,而我们能做的是在其中尝试寻找自己的位置。至少对于上面所列出的那些剩余问题,今天仍然还有一些探索空间。如果你关心图形学和3D,那可能意味着深入到渲染和物理的底层算法。在具身一侧,如果你真想解决问题,那意味着着手硬件和控制。我知道这些都位于我们这些“深度学习的人”的舒适区以外。但现实同样残酷:我们舒适区之内的事,以数据驱动的方式训练一个专用模型,或许已经一去不复返了。
本文改编自作者2026年9月15日在EIT HAI组会上的报告,略有编辑。感谢HAI同学们提供的演示demo。文中观点仅代表作者本人。
BibTeX
@article{zhu2026astra,
  title   = {GPT-6 Astra: 3D, Embodied AI, and Beyond},
  author  = {Zhu, Wentao},
  journal = {wentao.live},
  year    = {2026},
  month   = {September},
  url     = {https://wentao.live/blog/astra-and-beyond/}
}